BlogForschung zur KI-Sichtbarkeit
Warum empfiehlt ChatGPT Ihr Unternehmen nicht?
Markennennungen, Empfehlungen und Quellenangaben sind nicht dasselbe. Was aktuelle Studien zeigen und wie Sie eine verlässliche Baseline für Ihre Sichtbarkeit in ChatGPT aufbauen.
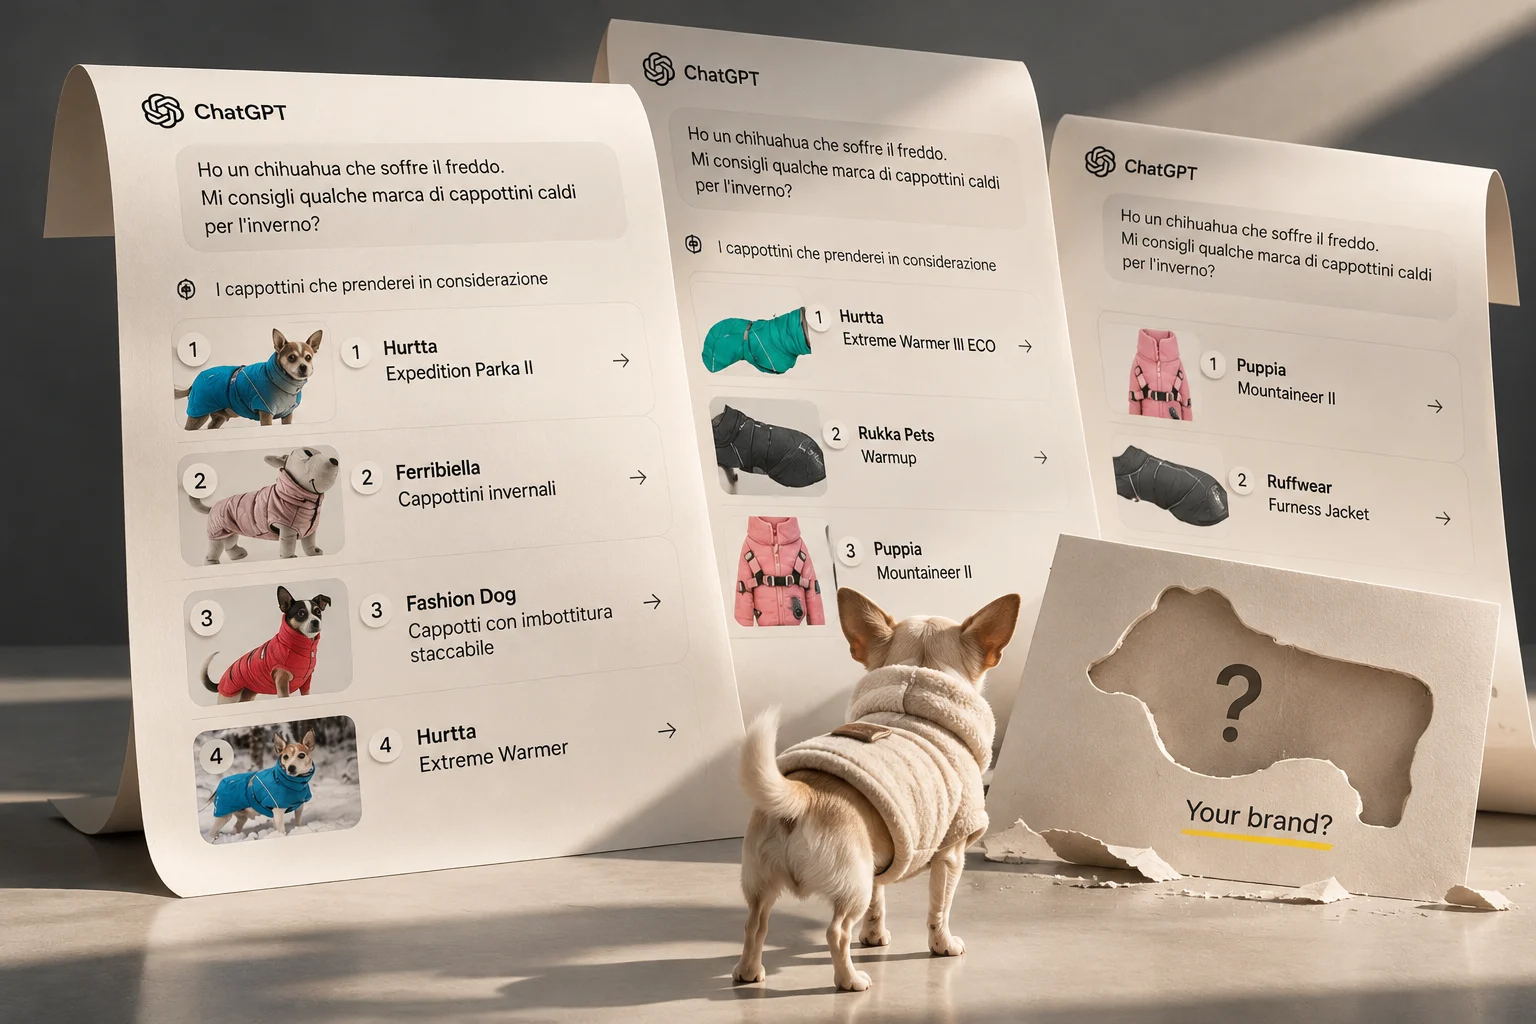
Sie bitten ChatGPT um eine Shortlist möglicher Lieferanten. Drei Wettbewerber tauchen auf. Ihr Unternehmen nicht. Beim zweiten Versuch kommt eine andere Liste heraus, und eine Kollegin bekommt wieder eine andere Antwort.
Die kommerzielle Sorge ist berechtigt. Die Diagnose fehlt aber noch.
Dass eine Empfehlung ausbleibt, kann an der Frage liegen, am Markt, an den verfügbaren Informationen oder an der einzelnen generierten Antwort. Es kann auch auf eine dauerhafte Schwäche im Wettbewerb hinweisen. Ein einzelner Screenshot kann diese Möglichkeiten nicht auseinanderhalten. Bevor Sie Ihre Website ändern, sollten Sie klären, was tatsächlich fehlt und ob sich dieses Fehlen in den Kaufsituationen wiederholt, auf die es ankommt.
Sinnvolles Ziel ist ein verlässliches Bild Ihres Relevant Sets: der Unternehmen, die ein Assistent für einen klar umrissenen Kundenbedarf in Betracht zieht. Dafür braucht es ein klareres Messsystem als ein vermeintliches „Ranking in ChatGPT“.
Nennung, Empfehlung und Quellenangabe sind verschiedene Beobachtungen
Eine Nennung bedeutet, dass die Antwort ein Unternehmen beim Namen nennt. Das kann als Option sein, als Wettbewerber, als historisches Beispiel oder als etwas, wovon abgeraten wird.
Eine Empfehlung ist eine positive Auswahl für den Bedarf, den der Nutzer beschrieben hat. „Prüfen Sie Unternehmen A, weil es die geforderte Zertifizierung unterstützt“ ist etwas anderes als „Unternehmen A bedient diesen Markt nicht“. Eine Empfehlung kann auch an Bedingungen geknüpft sein: passend für einen großen Hersteller, aber ungeeignet für eine kleine Bestellung.
Eine Quellenangabe verlinkt auf eine Quelle, die in der Antwort verwendet oder angezeigt wird. Das kann die Website des Lieferanten sein, eine Fachpublikation, ein Branchenverzeichnis oder eine Vergleichsseite. Ein Lieferant kann auf Grundlage fremder Belege empfohlen werden. Und seine eigene Seite kann als Quelle erscheinen, während die Antwort jemand anderen empfiehlt.
Erfassen Sie alle drei, dazu die sachliche Richtigkeit. Sonst wirkt eine Kampagne erfolgreich, weil die Quellenangaben gestiegen sind, obwohl sich bei den kommerziell relevanten Empfehlungen nichts getan hat.
Die Unterscheidung ist nicht nur theoretisch. In einem kleinen Experiment von Ahrefs, das ab Februar 2026 selbstwerbende Inhalte verfolgte, wurde eine Seite, die für eine Konferenz warb, teilweise als Quelle angegeben, ohne dass die beworbene Konferenz genannt wurde. Laut Bericht fiel die Konferenz in 43 % dieser Fälle mit Quellenangabe unter den Tisch. Es handelt sich um ein konkretes Experiment mit einer Konferenz und einem bekannten Produkt, nicht um eine allgemeine Fehlerquote für Listenartikel und auch nicht um eine kontrollierte Erklärung für das Verhalten jedes Assistenten. Das Experiment von Ahrefs und seine Einschränkungen
Auch eine instabile Liste kann ein stabiles Wettbewerbsmuster enthalten
Für ihre Studie vom Januar sammelten SparkToro und Gumshoe mit 600 Freiwilligen 2.961 Antworten auf 12 Prompts in ChatGPT, Claude und den KI-Suchfunktionen von Google. Exakt gleiche Listen wiederholten sich selten, und doch tauchten manche Marken häufig auf. Die Daten wurden im November und Dezember 2025 erhoben, mit den normalen Einstellungen der Teilnehmenden statt einheitlicher Bedingungen bei Land, Verlauf und Gerät. Fragen zur Stichprobengröße und zur Vergleichbarkeit mit der API ließen die Autoren ausdrücklich offen. Die ursprüngliche Methodik von SparkToro
Es wäre ein Fehler, aus „die ganze Liste hat sich geändert“ den Schluss „nichts lässt sich messen“ zu ziehen. Eine Liste mit fünf Unternehmen kann sich ändern, weil der fünfte Platz rotiert, während dieselben zwei Wettbewerber immer dabei sind. Ob sich eine Antwort exakt wiederholt und ob eine Marke beständig auftaucht, sind zwei verschiedene Eigenschaften.
Eine neuere Studie von Detailed verfolgte über 28 Tage mehr als 70.000 Antworten in ChatGPT und den Google AI Overviews, mit Prompts, die auf Kaufentscheidungen ausgerichtet waren. Die veröffentlichte Analyse trennt einen Kern von Marken, die an mindestens 80 % der Tage erschienen, vom übrigen Rest, dem sogenannten Long Tail. Im Kern war die Fluktuation von Tag zu Tag deutlich geringer. Die Studie prüfte außerdem, ob die in den ersten zwei Wochen ermittelten Spitzenreiter es auch in den folgenden zwei Wochen blieben, und verringerte so eine Form der Rückschauverzerrung. Sie räumt dennoch ein, dass ihre Prompts nur unvollkommene Stellvertreter für echte Unterhaltungen sind. Die Studie von Detailed vom September
Die veröffentlichten Werte zur täglichen Fluktuation zeigen den Unterschied:
| Plattform und Einheit | Kern | Long Tail |
|---|---|---|
| ChatGPT: Marken | 13 % | 78 % |
| Google AI Overviews: Marken | 11 % | 65 % |
| ChatGPT: zitierte Domains | 14 % | 74 % |
| Google AI Overviews: zitierte Domains | 12 % | 61 % |
Das sind aggregierte Kennzahlen der Studie für die Veränderung von Tag zu Tag. Es sind keine Fehlerquoten und auch nicht die Wahrscheinlichkeit, dass ein bestimmtes Unternehmen aus der nächsten Antwort verschwindet. Die Werte stammen aus der veröffentlichten Analyse von Detailed und wurden nicht unabhängig aus den zugrunde liegenden Antworten nachgerechnet.
Daraus ergibt sich für ein Unternehmen eine praktische Frage: Sind Wettbewerber immer wieder dabei, während Ihr Unternehmen immer wieder aus dem Relevant Set herausfällt? Das ist ein stärkerer Grund, genauer hinzusehen, als eine veränderte Reihenfolge in der Liste. Warum die Plattform so ausgewählt hat, verrät es Ihnen aber noch nicht.
01 Studienergebnis · Detailed, September 2026
Manche Marken bleiben. Andere wechseln.
Fluktuation der Marken in KI-Antworten von Tag zu Tag. Der häufig erscheinende Kern verändert sich weit weniger als der übrige Long Tail.
- Kern · an ≥80 % der Tage erschienen
- Long Tail · übrige Marken
ChatGPTMarken · tägliche Fluktuation
Google AI OverviewsMarken · tägliche Fluktuation
Was das für die Praxis heißt: Wechselnde Empfehlungslisten bedeuten nicht zwangsläufig, dass jede Marke gleich instabil ist. Achten Sie auf Wettbewerber, die bei relevanten Fragen immer wieder auftauchen.
Quelle: Detailed, Studie zur KI-Volatilität (September 2026). Veröffentlichte aggregierte Kennzahlen zur täglichen Fluktuation aus einer 28-tägigen Analyse von mehr als 70.000 Antworten. Es handelt sich nicht um Fehlerquoten oder um die Wahrscheinlichkeit, dass ein einzelnes Unternehmen aus der nächsten Antwort verschwindet. Die Werte sind der Quelle des Artikels entnommen und wurden nicht unabhängig nachgerechnet.
Markt und Suchintention gehören in die Messung
„Empfiehl mir einen Verpackungslieferanten“ ist kein ausreichend definierter Wettbewerbstest. Ein britischer Lebensmittelhersteller, der zertifizierte Verpackungen in kleinen Mengen sucht, hat andere Anforderungen als ein US-Distributor, der eine ganze Containerladung einkauft. Sprache, Liefergebiet, Bestellmenge, Zertifizierung und Phase im Einkaufsprozess können alle verändern, was eine gute Antwort ist.
Der Benchmark von Semrush für Großbritannien und die USA vom Oktober unterstreicht, dass man segmentieren muss. Von Januar bis Juli deckten die festen monatlichen Prompt-Sets 2,5 Millionen Prompts in Großbritannien und 25 Millionen in den USA für ChatGPT, Gemini und den KI-Modus ab, dazu kam ein separater, variabler Datensatz für die AI Overviews. Die paarweise Überschneidung unter den 100 meistgenannten Marken war in Großbritannien geringer als in den USA. Das sind Benchmark-Ergebnisse auf Marktebene, keine zu erwartenden Sichtbarkeitswerte für einen B2B-Lieferanten. Die Pressemitteilung von Semrush zur Oktober-Studie
In den veröffentlichten Benchmarks teilten zwei beliebige Plattformen in Großbritannien zwischen 63 und 70 ihrer 100 meistgenannten Marken, in den USA zwischen 70 und 78. Diese Spannen beschreiben die beobachtete Überschneidung im Benchmark, keine Konfidenzintervalle. Sie betreffen die Zugehörigkeit zur Liste, nicht die Übereinstimmung in der Reihenfolge und nicht den Anteil aller Antworten, in denen ein Unternehmen genannt wird.
Das Prompt-Universum eines Sichtbarkeitstools zählt genauso viel wie der Wert, der am Ende herauskommt. Die aktuelle Methodikseite von Semrush beschreibt den heutigen, erweiterten Index; die herunterladbare Oktober-Studie hat ihren eigenen Rahmen. Werfen Sie Zahlen aus dem sich ständig ändernden Live-Index nicht mit einem historischen Bericht zusammen, als beschrieben beide ein einziges, festes Experiment. Die Überschneidungskennzahl zählt gemeinsame Listeneinträge, nicht die Übereinstimmung in der Reihenfolge. Die Methodik von Semrush
Für Ihre eigene Baseline gilt: Ein übersetzter Prompt ist eine neue Messbedingung. Halten Sie Tests auf Deutsch für Deutschland, für Österreich und für die Schweiz getrennt, ebenso Tests auf Englisch. Wenn Sie von Wien aus testen und „in Deutschland“ in den Prompt schreiben, legen Sie damit den Zielmarkt fest; zu einem Test aus Deutschland wird die Sitzung dadurch nicht. Halten Sie beides fest.
Bauen Sie die Baseline auf echten Einkaufsentscheidungen auf
Ein kleines B2B-Panel sollte mit der Sprache Ihrer Kunden beginnen: Vertriebsanfragen, Anforderungen aus dem Einkauf, Gespräche im Support und die Gründe, aus denen Interessenten Lieferanten aussortieren. Entfernen Sie vertrauliche Details, bevor Sie diese Formulierungen verwenden. Eine Liste mit Google-Keywords kann Themen liefern, sie bildet aber nicht ab, wie echte ChatGPT-Unterhaltungen verteilt sind.
Der folgende Pilot ist ein von Search Orchard vorgeschlagenes Protokoll. Er wurde nicht durchgeführt, und dieser Artikel beansprucht keine Ergebnisse aus einem eigenen ChatGPT-Experiment. Die Vergleichszahlen hier stammen aus veröffentlichten, namentlich genannten Studien. Ein kleiner, hastiger Test würde weniger bringen als eine reproduzierbare Methode, deren Grenzen offen liegen.
Beginnen Sie mit sechs Fragen zu einer Leistungskategorie und einem Zielmarkt. Zum Beispiel:
- „Welche Lieferanten in Deutschland sollte ein kleiner Lebensmittelhersteller für recycelbare Standbodenbeutel mit niedrigen Mindestbestellmengen in Betracht ziehen?“
- „Wir brauchen lebensmittelechte Standbodenbeutel mit Lieferung nach Köln. Welche Lieferanten nennen Mindestbestellmengen und Lieferzeiten klar?“
- „Welche Verpackungslieferanten in Deutschland belegen die Lebensmittelkonformität ihrer Standbodenbeutel?“
- „Welche Lieferanten sollte eine wachsende deutsche Lebensmittelmarke für bedruckte, recycelbare Beutel und Nachbestellungen vergleichen?“
- „Welche Lieferanten eignen sich für ein deutsches Unternehmen, das ein neues Lebensmittel testet, bevor es eine große Verpackungsbestellung aufgibt?“
- „Wir vergleichen Lieferanten für recycelbare Lebensmittelbeutel in Deutschland. Welche Unternehmen erklären Material, Mindestbestellmengen und Lieferbedingungen verständlich?“
Das sind realistische Beispiele, keine Behauptung, dass die genannten Lieferanten die Anforderungen tatsächlich erfüllen. Aussagen zu Nachhaltigkeit und Konformität von Verpackungen müssen unabhängig geprüft werden. Die bewusst verwandten Prompts testen unterschiedliche Einkaufsbedingungen innerhalb einer Kategorie, statt fremde Branchen zu einer eindrucksvoll wirkenden Gesamtzahl zu vermischen.
Stellen Sie jede Frage fünfmal, jedes Mal in einer neuen Unterhaltung. Das ergibt 30 geplante Beobachtungen pro Messrunde. Wiederholen Sie dasselbe Panel an einem zweiten Termin, bevor Sie etwas an der Website ändern. Das ist eine pragmatische Pilotgröße, um Muster und Probleme bei der Kodierung zu erkennen, kein statistisch abgesichertes Minimum und kein repräsentativer Ausschnitt der Kundennachfrage. Ein passendes Panel für Österreich, die Schweiz oder einen englischsprachigen Markt nehmen Sie nur als eigene Kohorte hinzu.
Halten Sie Produktoberfläche, angezeigte Modellbezeichnung, Sucheinstellung und Kontokontext konstant. Protokollieren Sie Zeitpunkt, Zeitzone, Gerät, Sprache der Oberfläche, Zielmarkt, tatsächlichen Standort der Sitzung sowie den Status von Memory und benutzerdefinierten Anweisungen. Erfassen Sie, was die Oberfläche anzeigt; erfinden Sie keine verborgenen Temperatureinstellungen oder Versionskennungen des Modells. Wenn Sie stattdessen eine API nutzen, nennen Sie Endpunkt und Modell-ID und weisen Sie das Ganze als API-Studie aus. Deren Ergebnisse sind nicht automatisch mit der Verbraucheroberfläche gleichzusetzen.
Speichern Sie die vollständige Antwort und die verlinkten Quellen, nicht nur einen Screenshot der ersten paar Namen. Protokollieren Sie Fehler, Verweigerungen und Antworten ohne Marken. Wenden Sie in jeder Runde dieselben Einschlussregeln an.
02 Vorgeschlagene Methode · noch nicht durchgeführt
Eine Antwort ist keine Baseline.
Ein einfaches Protokoll für den Anfang: Markt und Leistungskategorie bleiben gleich, die tatsächlichen Anforderungen der Einkäufer variieren, und jede Frage wird wiederholt, bevor Sie Ergebnisse vergleichen.
- Schritt 016EinkaufsfragenEine Produkt- oder Leistungskategorie. Ein Zielmarkt.
- Schritt 025×Neue UnterhaltungenJede Frage fünfmal unter protokollierten Bedingungen wiederholen.
- Schritt 0330Geplante BeobachtungenJede vollständige Antwort samt verlinkten Quellen aufbewahren.
Sechs alltägliche Anforderungen im Einkauf, die Sie testen können
An einem zweiten Termin wiederholen. Vergleichen Sie die Muster aus zwei Messrunden, bevor Sie eine Verbesserung oder ein dauerhaftes Fehlen behaupten.
Veranschaulichung der in diesem Artikel beschriebenen Methode, keine abgeschlossene Untersuchung und keine beobachteten Empfehlungszahlen. Dreißig ist eine pragmatische Pilotgröße, keine statistisch repräsentative Stichprobe. Halten Sie fehlgeschlagene Durchläufe getrennt und protokollieren Sie die Bedingungen, unter denen die Antworten entstanden sind.
Präsenz messen, ohne den Nenner zu verstecken
Die wichtigste Kennzahl sollte ohne die Software verständlich sein, die sie erzeugt hat:
Empfehlungshäufigkeit = gültige Antworten, die das Unternehmen empfehlen ÷ alle gültigen Antworten im definierten Panel.
Zählen Sie eine Marke einmal pro Antwort, auch wenn sie mehrmals vorkommt. Nehmen Sie gültige Antworten, die gar keinen Lieferanten empfehlen, in den Nenner auf. Halten Sie Übertragungsfehler und fehlgeschlagene Durchläufe getrennt und geben Sie die Abschlussquote an. Eine Verweigerung oder eine Rückfrage ist trotzdem ein beobachtetes Ergebnis des Produkts; legen Sie offen, wie Sie sie eingeordnet haben, und nennen Sie die Anzahl, statt sie stillschweigend auszusortieren.
Weisen Sie die Häufigkeit von Nennungen und Quellenangaben getrennt aus. Unterscheiden Sie bei den Quellenangaben zwischen Links auf die Domain des Unternehmens und unabhängigen Quellen, die über das Unternehmen berichten. Führen Sie bekannte Namensvarianten eines Unternehmens sorgfältig zusammen und halten Sie ähnlich benannte Firmen auseinander. Bewahren Sie den Originaltext auf, damit sich strittige Einordnungen überprüfen lassen.
Vergleichen Sie die Ergebnisse pro Frage, bevor Sie sie zusammenfassen. Fünfzehn Auftritte in 30 Antworten können bedeuten, dass ein Lieferant drei Anforderungen dominiert und bei den anderen drei fehlt. Eine einzige Schlagzeile mit 50 % verdeckt diesen nützlichen Unterschied. In einer größeren Studie sollte eine Matrix aus Prompts und Marken in jeder Zelle Anzahl und Nenner zeigen, wobei Fehlschläge getrennt von null Empfehlungen markiert sind.
Behandeln Sie wiederholte Durchläufe als korrelierte Beobachtungen, nicht als 30 unabhängige Kunden. Zeigen Sie bei einem kleinen Pilot Anzahlen, Termine und die Spannweite zwischen den Fragen. Wenn Sie formale Unsicherheitsschätzungen brauchen, berücksichtigen Sie die Clusterung nach Prompt und Termin. Ein enges binomiales Konfidenzintervall, das jeden Durchlauf als unabhängig behandelt, kann mehr Genauigkeit vorspiegeln, als das Design hergibt.
Behalten Sie ein festes Kernpanel für Vergleiche bei und dokumentieren Sie explorative Fragen getrennt. Wer nach einem Website-Update leichtere Prompts in den Nenner aufnimmt, kann eine Verbesserung der Sichtbarkeit erzeugen, ohne dass sich an der Wettbewerbsposition etwas geändert hat.
Was sich verbessern lässt, und wie belastbar sind die Belege?
Technischer Zugang spielt eine dokumentierte Rolle. OpenAI nennt OAI-SearchBot als seinen Such-Crawler und grenzt ihn von GPTBot ab, bei dem es um ein mögliches Modelltraining geht. Wer den ersten blockiert, schließt seine Website von den Suchantworten in ChatGPT aus, auch wenn Navigationslinks weiterhin erscheinen können. Den Crawler zuzulassen, beseitigt eine Zugangshürde; eine Empfehlung garantiert es nicht. Prüfen Sie neben der robots.txt auch das Verhalten von CDN und Firewall. Die Crawler-Dokumentation von OpenAI
Klare geschäftliche Fakten sind eine solide redaktionelle Investition. Erklären Sie, wen das Unternehmen bedient, wohin es liefert, was es anbietet und welche Einschränkungen gelten. Stellen Sie überprüfbare Spezifikationen und Grenzen auf die passenden Leistungs- oder Produktseiten. Das hilft einem potenziellen Käufer, das Unternehmen einzuschätzen, und liefert Retrieval-Systemen verwertbares Material. Wie sehr eine bestimmte Überarbeitung die Empfehlungen tatsächlich steigert, bleibt etwas, das Sie testen müssen, kein garantiertes Ergebnis.
Unabhängige Belege verdienen einen genauen Blick, ohne erfundene Gewichtungsregeln. Sehen Sie sich die Quellen an, die bei den Kaufsituationen in Ihrem Panel immer wieder zitiert werden. Beschreiben relevante Branchenverbände, Verzeichnisse, Fachpublikationen oder Kundenbewertungen das Unternehmen korrekt? Korrigieren Sie Fehler und bemühen Sie sich um seriöse Berichterstattung, wo sie Kunden tatsächlich nützt. Ein Zusammenhang zwischen Präsenz auf Drittseiten und KI-Sichtbarkeit beweist nicht, dass gekaufte Erwähnungen zu einer Empfehlung führen.
Bei Abkürzungen über das Format ist Skepsis angebracht. Keine öffentlich verfügbaren Belege zeigen ein allgemeingültiges Formulierungsmuster, eine Schema-Kombination oder eine llms.txt-Datei, mit der ChatGPT einen Lieferanten empfiehlt. Google sagt ausdrücklich, dass seine eigenen KI-Suchfunktionen weder eine spezielle KI-Datei noch ein besonderes Schema brauchen; diese Aussage betrifft Google und sollte nicht als Vorgabe von OpenAI dargestellt werden. Behandeln Sie plattformspezifische Experimente als das, was sie sind: Experimente. Die dokumentierten Anforderungen von Google
Eine selbstwerbende Liste, die Quellenangaben einbringt, kann auch Ihre Wettbewerber empfehlen. Genau deshalb ist das Experiment von Ahrefs wichtig: Ziel muss sein, dass Ihr Unternehmen für den richtigen Bedarf korrekt in Betracht gezogen wird, nicht nur ein Link auf eine Seite, die Sie veröffentlicht haben.
Die Lücke diagnostizieren, bevor Sie die Arbeit wählen
Fehlt das Unternehmen bei wiederholten, relevanten Fragen, prüfen Sie Zugang, Faktenlage und die unabhängigen Quellen, die mit seiner Kategorie verbunden sind. Taucht es bei manchen Anforderungen auf, bei anderen nicht, klären Sie, ob dieser Unterschied eine echte Grenze des Angebots widerspiegelt. Wird es mit falschen Fakten empfohlen, hat die Richtigkeit Vorrang.
Steigt die Sichtbarkeit, die Zahl der Anfragen aber nicht, ist die nächste Frage eine kaufmännische. Haben die getesteten Anforderungen Wert? Stellen echte Interessenten diese Fragen? Landen die Verweise auf einer nützlichen Seite? Der Zusammenhang zwischen KI-Shopping und Umsatz ist größer als eine Zählung von Markennennungen, und die KI-Berichte von Google messen wieder eine andere Plattform und eine andere Einheit.
Eine Analyse Ihrer Sichtbarkeit in der KI-Suche sollte diese Grenzen offen benennen. Am Ende sollten Sie eine definierte Baseline, aufbewahrte Belege und Prioritäten haben, die zu Ihrem Unternehmen passen, statt eines Versprechens, „auf Platz eins in ChatGPT“ zu kommen.
Vielleicht hat Ihr Unternehmen ein Sichtbarkeitsproblem. Dieses Problem sorgfältig festzustellen, ist der erste sinnvolle Schritt der Optimierung.