BlogRicerca sulla visibilità AI
Perché ChatGPT non consiglia la tua azienda?
Menzioni del brand, consigli e citazioni sono cose diverse. Cosa dicono le ricerche più recenti e come costruire una baseline affidabile della tua visibilità su ChatGPT.
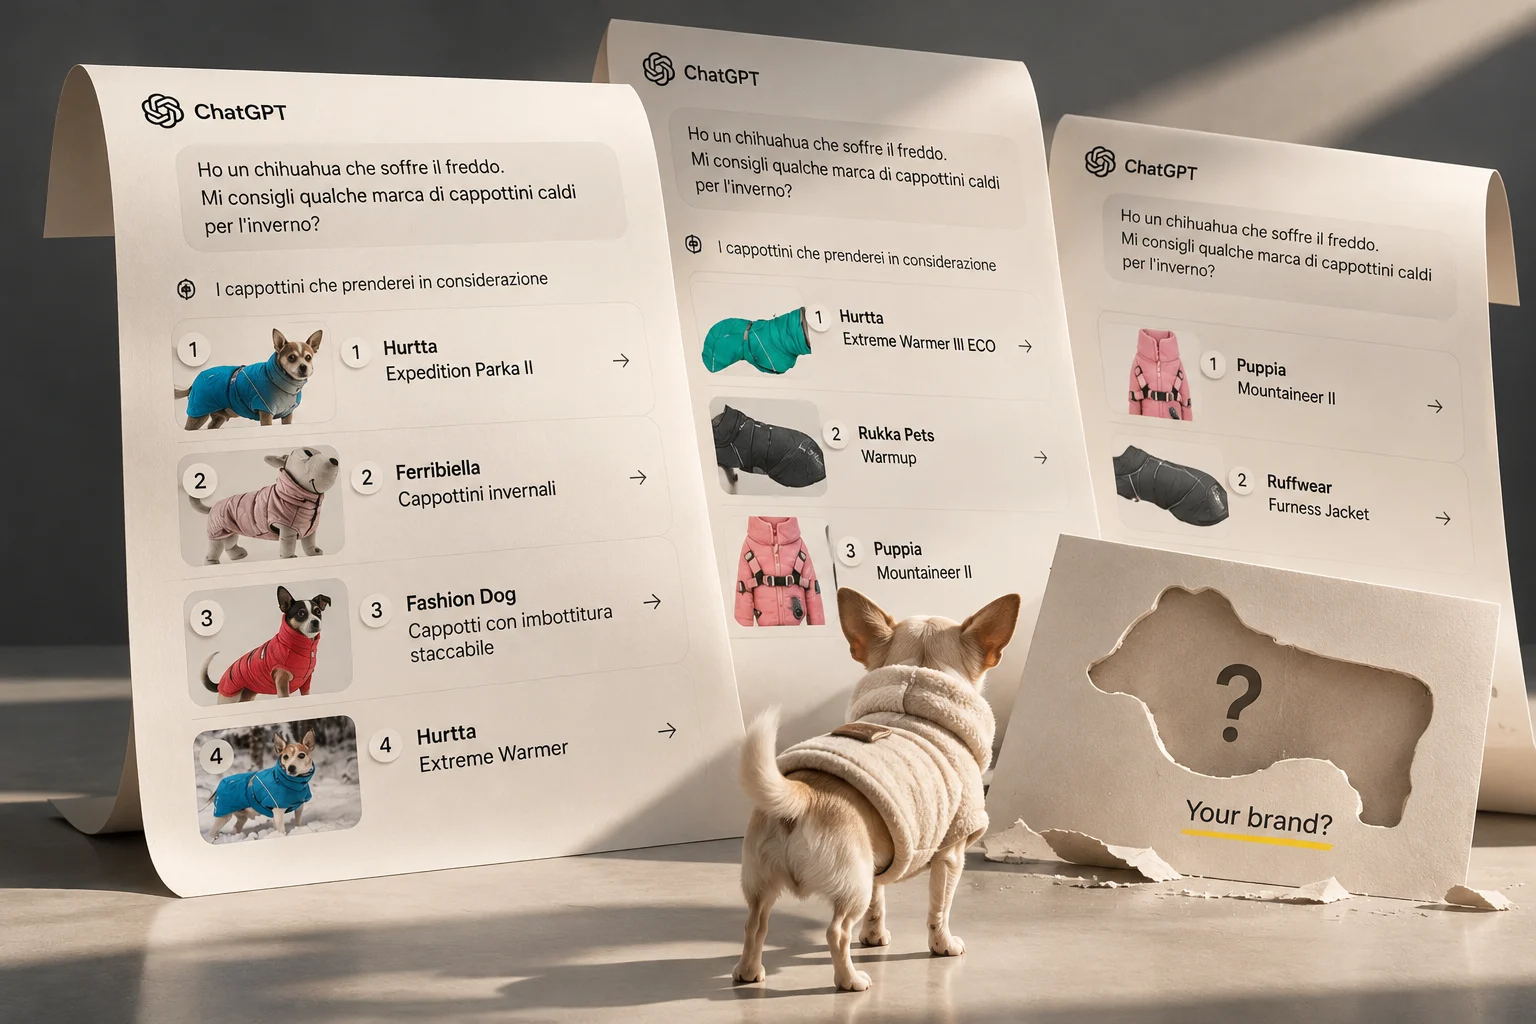
Chiedi a ChatGPT una rosa di fornitori. Compaiono tre concorrenti. La tua azienda no. Al secondo tentativo esce un elenco diverso, e un collega riceve un’altra risposta ancora.
La preoccupazione commerciale è legittima. La diagnosi, però, ancora manca.
Un consiglio assente può dipendere dalla domanda, dal mercato, dalle informazioni disponibili o dalla singola risposta generata. Può anche rivelare una debolezza competitiva che persiste. Un solo screenshot non basta a distinguere tra queste possibilità. Prima di modificare il sito, stabilisci che cosa manca davvero e se quell’assenza si ripete nelle situazioni d’acquisto che contano.
L’obiettivo utile è un quadro affidabile del tuo insieme competitivo: le aziende che un assistente prende in considerazione per un’esigenza precisa del cliente. Per ottenerlo serve un sistema di misurazione più chiaro di un presunto “posizionamento su ChatGPT”.
Menzione, consiglio e citazione sono osservazioni diverse
Una menzione significa che la risposta nomina un’azienda. Può nominarla come opzione, come concorrente, come esempio storico o come qualcosa da evitare.
Un consiglio è una scelta positiva rispetto all’esigenza dichiarata dall’utente. “Valuta l’Azienda A perché ha la certificazione richiesta” è diverso da “L’Azienda A non serve quel mercato”. Un consiglio può anche essere condizionato: adatto a un grande produttore ma non a un ordine piccolo.
Una citazione è un link a una fonte usata o mostrata nella risposta. Quella fonte può essere il sito del fornitore, una testata di settore, una directory o una pagina di confronto. Un fornitore può essere consigliato sulla base delle informazioni di qualcun altro. E la sua pagina può essere citata mentre la risposta consiglia qualcun altro.
Registra tutte e tre, più l’accuratezza dei fatti. Altrimenti una campagna può sembrare un successo perché le citazioni sono aumentate, mentre i consigli che contano commercialmente sono rimasti invariati.
La distinzione non è solo teorica. In un piccolo esperimento di Ahrefs che ha monitorato contenuti autopromozionali a partire da febbraio 2026, una pagina che promuoveva una conferenza veniva a volte citata senza che la conferenza promossa fosse nominata. Il report ha rilevato che la conferenza veniva omessa nel 43% di quei casi di citazione. Si tratta di un esperimento specifico, che riguarda una conferenza e un prodotto noto, non di un tasso di fallimento universale per gli articoli a elenco né di una spiegazione controllata del comportamento di ogni assistente. L’esperimento di Ahrefs e i suoi limiti
Un elenco instabile può contenere uno schema competitivo stabile
La ricerca di gennaio di SparkToro e Gumshoe ha raccolto 2.961 risposte a 12 prompt su ChatGPT, Claude e le esperienze di ricerca AI di Google, con 600 volontari. Gli elenchi identici si ripetevano raramente, eppure alcuni brand comparivano spesso. La raccolta si è svolta tra novembre e dicembre 2025, con le normali impostazioni dei partecipanti e non con condizioni uniformi di paese, cronologia e dispositivo. Gli autori hanno lasciato esplicitamente aperte le questioni sulla dimensione del campione e sull’equivalenza con le API. La metodologia originale di SparkToro
Sarebbe un errore trasformare “l’elenco completo è cambiato” in “non si può misurare nulla”. Un elenco di cinque aziende può cambiare perché la quinta ruota, mentre gli stessi due concorrenti restano sempre presenti. La ripetibilità della risposta esatta e la persistenza del singolo brand misurano proprietà diverse.
Uno studio più recente di Detailed ha seguito oltre 70.000 risposte di ChatGPT e degli AI Overviews di Google per 28 giorni, con prompt di taglio commerciale. L’analisi pubblicata separa un nucleo di brand presenti in almeno l’80% dei giorni dalla coda restante. Il ricambio giornaliero era molto più basso nel nucleo. Lo studio ha anche verificato i leader individuati nelle prime due settimane rispetto alle due successive, riducendo una forma di distorsione a posteriori. Riconosce comunque che i suoi prompt sono approssimazioni imperfette delle conversazioni reali. Lo studio di Detailed di settembre
I dati pubblicati sul ricambio giornaliero mostrano la differenza:
| Piattaforma ed entità | Nucleo | Coda |
|---|---|---|
| ChatGPT: brand | 13% | 78% |
| AI Overviews di Google: brand | 11% | 65% |
| ChatGPT: domini citati | 14% | 74% |
| AI Overviews di Google: domini citati | 12% | 61% |
Sono le misure aggregate di variazione giornaliera dello studio. Non sono tassi di errore né la probabilità che una determinata azienda sparisca dalla risposta successiva. I valori sono ripresi dall’analisi pubblicata da Detailed, non ricalcolati in modo indipendente a partire dalle risposte originali.
Questo suggerisce una domanda pratica per un’azienda: i concorrenti sono presenti in modo ricorrente mentre la tua azienda resta ripetutamente fuori dall’insieme considerato? È un motivo per indagare molto più forte di un cambiamento nell’ordine dell’elenco. Ma non ti dice ancora perché la piattaforma ha fatto quelle scelte.
01 Risultato di ricerca · Detailed, settembre 2026
Alcuni brand restano. Altri cambiano.
Ricambio giornaliero dei brand mostrati nelle risposte AI. Il nucleo che compare spesso cambia molto meno della coda restante.
- Nucleo · Presente in ≥80% dei giorni
- Coda · Altri brand
ChatGPTBrand · ricambio giornaliero
AI Overviews di GoogleBrand · ricambio giornaliero
In pratica: elenchi di consigli che cambiano non significano per forza che tutti i brand siano ugualmente instabili. Cerca i concorrenti che continuano a ricomparire nelle domande pertinenti.
Fonte: Detailed, studio sulla volatilità dell’AI (settembre 2026). Misure aggregate pubblicate del ricambio giornaliero, da un’analisi di 28 giorni su oltre 70.000 risposte. Non sono tassi di errore né la probabilità che una singola azienda sparisca dalla risposta successiva. I valori sono citati dalla fonte dell’articolo, non ricalcolati in modo indipendente.
Mercato e intento fanno parte della misurazione
“Consigliami un fornitore di imballaggi” non è un test competitivo abbastanza definito. Un produttore alimentare britannico che cerca imballaggi certificati in piccole quantità ha esigenze diverse da un distributore statunitense che compra un container intero. Lingua, area di consegna, dimensione dell’ordine, certificazioni e fase d’acquisto possono cambiare che cosa sia una buona risposta.
Il benchmark di Semrush di ottobre su Regno Unito e Stati Uniti conferma la necessità di segmentare. Tra gennaio e luglio, i suoi set mensili di prompt fissi hanno coperto 2,5 milioni di prompt nel Regno Unito e 25 milioni negli Stati Uniti per ChatGPT, Gemini e AI Mode, con un dataset separato e variabile per gli AI Overviews. La sovrapposizione a coppie tra i primi 100 brand menzionati era più bassa nel Regno Unito che negli Stati Uniti. Sono risultati di benchmark a livello di mercato, non punteggi di visibilità attesi per un fornitore B2B. Il comunicato di Semrush sullo studio di ottobre
Nei benchmark riportati, due piattaforme qualsiasi condividevano tra 63 e 70 dei loro primi 100 brand menzionati nel Regno Unito, contro tra 70 e 78 negli Stati Uniti. Questi intervalli descrivono la sovrapposizione osservata nel benchmark, non intervalli di confidenza. Riguardano la presenza negli elenchi, non l’accordo sull’ordine né la quota di tutte le risposte che menzionano un’azienda.
L’universo di prompt di uno strumento di visibilità conta quanto il punteggio che ne risulta. La pagina sulla metodologia di Semrush descrive l’indice attuale, ampliato; lo studio di ottobre scaricabile ha un perimetro suo. Non combinare i numeri dell’indice live, che cambia, con un report storico dando per scontato che descrivano un unico esperimento fisso. La sua misura di sovrapposizione conta i membri condivisi degli elenchi, non l’accordo sull’ordine. La metodologia di Semrush
Per la tua baseline, un prompt tradotto è una nuova condizione di misurazione. Tieni separati i test in inglese britannico, inglese americano e italiano. Se l’account si trova fisicamente in Italia, scrivere “nel Regno Unito” nel prompt indica il mercato di riferimento; non rende la sessione un test eseguito dal Regno Unito. Registra entrambe le cose.
Costruisci la baseline sulle decisioni reali di acquisto
Un piccolo panel B2B dovrebbe partire dal linguaggio dei clienti: richieste commerciali, requisiti degli uffici acquisti, conversazioni con l’assistenza e i motivi per cui i potenziali clienti scartano un fornitore. Elimina i dettagli riservati prima di usarli. Un elenco di keyword di Google può suggerire degli argomenti, ma non rappresenta la distribuzione delle conversazioni reali su ChatGPT.
Il pilota che segue è un protocollo proposto da Search Orchard. Non è stato eseguito, e questo articolo non presenta alcun risultato di esperimenti originali su ChatGPT. I confronti numerici qui riportati vengono da studi pubblicati e citati. Un piccolo test fatto di fretta aggiungerebbe meno valore di un metodo riproducibile con i suoi limiti in vista.
Parti da sei domande per una categoria di servizio e un mercato di riferimento. Per esempio, per il mercato italiano:
- “Quali fornitori italiani dovrebbe valutare un piccolo produttore alimentare per buste stand-up riciclabili, con quantitativi minimi d’ordine bassi?”
- “Ci servono buste stand-up per alimenti consegnate a Milano. Quali fornitori indicano chiaramente minimi d’ordine e tempi di consegna?”
- “Quali fornitori italiani di imballaggi documentano la conformità al contatto con gli alimenti per le buste stand-up?”
- “Quali fornitori dovrebbe confrontare un marchio alimentare italiano in crescita per buste riciclabili stampate e riordini?”
- “Quali fornitori sono adatti a un’azienda italiana che sta testando un nuovo prodotto alimentare prima di impegnarsi in un grande ordine di imballaggi?”
- “Stiamo confrontando fornitori italiani di buste riciclabili per alimenti. Quali aziende spiegano chiaramente materiali, minimi d’ordine e condizioni di consegna?”
Sono esempi realistici, non un’affermazione che i fornitori restituiti rispettino davvero quei requisiti. Le dichiarazioni sulla sostenibilità e sulla conformità degli imballaggi vanno verificate in modo indipendente. I prompt, volutamente collegati tra loro, mettono alla prova vincoli d’acquisto diversi all’interno di una stessa categoria, invece di mescolare settori diversi per ottenere un totale che fa colpo.
Fai ogni domanda cinque volte, ogni volta in una conversazione nuova: sono 30 osservazioni pianificate per ciascuna rilevazione. Ripeti lo stesso panel in una seconda data prima di modificare il sito. È una dimensione pilota pragmatica, utile per individuare schemi e problemi di classificazione, non un minimo statisticamente validato né una quota rappresentativa della domanda dei clienti. Aggiungi un panel equivalente per il Regno Unito o per gli Stati Uniti solo come gruppo separato.
Mantieni costanti la superficie del prodotto, l’etichetta del modello visibile, l’impostazione di ricerca e il contesto dell’account. Registra data e ora, fuso orario, dispositivo, lingua dell’interfaccia, mercato di riferimento, posizione effettiva della sessione e lo stato della Memoria e delle istruzioni personalizzate. Registra ciò che l’interfaccia mostra; non inventare impostazioni di temperatura nascoste o identificativi di versione del modello. Se invece usi un’API, indica l’endpoint e l’ID del modello e presenta il lavoro come uno studio via API. I suoi risultati non sono automaticamente equivalenti a quelli dell’interfaccia per i consumatori.
Salva la risposta completa e le fonti collegate, non solo uno screenshot dei primi nomi. Registra errori, rifiuti e risposte senza brand. Usa le stesse regole di inclusione in ogni rilevazione.
02 Metodo proposto · Non ancora eseguito
Una risposta non è una baseline.
Un protocollo semplice da cui partire: mantieni costanti il mercato e la categoria di servizio, varia i requisiti reali di chi compra e ripeti ogni domanda prima di confrontare i risultati.
- Passo 016Domande d’acquistoUna categoria di prodotto o servizio. Un mercato di riferimento.
- Passo 025×Conversazioni nuoveRipeti ogni domanda cinque volte in condizioni registrate.
- Passo 0330Osservazioni pianificateConserva ogni risposta completa e le fonti collegate.
Sei esigenze d’acquisto quotidiane da testare
Ripeti in una seconda data. Confronta gli schemi di due rilevazioni prima di dichiarare un miglioramento o un’assenza persistente.
Illustrazione del metodo descritto in questo articolo, non una ricerca completata né conteggi di consigli osservati. Trenta è una dimensione pilota pragmatica, non un campione statisticamente rappresentativo. Tieni separate le esecuzioni non riuscite e registra le condizioni in cui le risposte sono state generate.
Misura la presenza senza nascondere il denominatore
Il tasso principale deve essere comprensibile senza il software che lo ha prodotto:
Frequenza dei consigli = risposte valide che consigliano l’azienda ÷ tutte le risposte valide del panel definito.
Conta un brand una sola volta per risposta, anche se compare più volte. Includi nel denominatore le risposte valide che non consigliano alcun fornitore. Tieni separati gli errori di trasmissione e le esecuzioni non riuscite, e riporta il tasso di completamento. Un rifiuto o una richiesta di chiarimento è comunque un risultato osservato del prodotto: spiega come l’hai classificato e mostrane il conteggio invece di scartarlo in silenzio.
Pubblica separatamente la frequenza delle menzioni e quella delle citazioni. Per le citazioni, distingui i link al dominio dell’azienda dalle fonti indipendenti che ne parlano. Normalizza con attenzione gli alias noti dell’azienda, tenendo separate le società con nomi simili. Conserva il testo originale, così le classificazioni contestate si possono verificare.
Confronta i risultati domanda per domanda prima di aggregarli. Quindici presenze su 30 risposte possono significare che un fornitore domina tre esigenze ed è assente dalle altre tre. Un unico dato del 50% nasconde questa distinzione utile. In uno studio più ampio, una matrice prompt per brand dovrebbe mostrare in ogni cella sia il conteggio sia il denominatore, con gli errori segnati separatamente dai casi con zero consigli.
Tratta le esecuzioni ripetute come osservazioni correlate, non come 30 clienti indipendenti. Per un piccolo pilota, mostra conteggi, date e intervalli tra le domande. Se servono stime formali dell’incertezza, tieni conto del raggruppamento per prompt e per data. Un intervallo di confidenza binomiale stretto, basato sull’idea che ogni esecuzione sia indipendente, può suggerire più precisione di quanta il disegno ne consenta.
Mantieni un panel di base fisso per i confronti e documenta a parte le eventuali domande esplorative. Aggiungere prompt più facili al denominatore dopo un aggiornamento del sito può fabbricare un miglioramento della visibilità senza alcun cambiamento nella posizione competitiva.
Cosa si può migliorare, e quanto sono solide le prove?
L’accesso tecnico ha un ruolo documentato. OpenAI identifica OAI-SearchBot come il suo crawler di ricerca e lo distingue da GPTBot, che riguarda il possibile addestramento dei modelli. Bloccare il primo esclude un sito dalle risposte di ricerca di ChatGPT, anche se possono comparire ancora link di navigazione. Consentire il crawler elimina un ostacolo all’accesso; non garantisce un consiglio. Verifica il comportamento della CDN e del firewall, oltre al robots.txt. La documentazione di OpenAI sui crawler
Informazioni commerciali chiare sono un investimento editoriale sensato. Spiega a chi si rivolge l’azienda, dove consegna, che cosa fornisce e quali vincoli valgono. Metti specifiche verificabili e limiti nelle pagine di servizio o di prodotto pertinenti. Questo aiuta un potenziale cliente a valutare l’azienda e dà ai sistemi di recupero delle informazioni materiale utilizzabile. L’aumento dei consigli dovuto a una specifica riscrittura resta qualcosa da verificare, non un risultato garantito.
Le fonti indipendenti meritano un’analisi, senza inventare regole di ponderazione. Guarda quali fonti vengono citate ripetutamente per le situazioni d’acquisto del tuo panel. Le associazioni di categoria, le directory, le pubblicazioni specializzate o le recensioni dei clienti pertinenti descrivono l’azienda in modo accurato? Correggi gli errori e cerca una copertura legittima dove è utile ai clienti. Una correlazione tra visibilità su fonti terze e visibilità nell’AI non dimostra che comprare menzioni porterà a un consiglio.
Le scorciatoie di formato vanno prese con scetticismo. Nessuna prova pubblica dimostra l’esistenza di una formula di scrittura, di una combinazione di schema o di un file llms.txt universali che facciano consigliare un fornitore a ChatGPT. Google dice esplicitamente che le sue funzioni di ricerca AI non richiedono file AI o schema speciali; quell’affermazione riguarda Google e non va presentata come una specifica di OpenAI. Tratta gli esperimenti specifici di una piattaforma come esperimenti. I requisiti documentati da Google
Un elenco autopromozionale che ottiene citazioni può anche finire per consigliare i tuoi concorrenti. Per questo l’esperimento di Ahrefs è importante: il risultato che conta è che l’azienda venga presa in considerazione in modo accurato per l’esigenza giusta, non semplicemente un link a una pagina che hai pubblicato.
Diagnostica il divario prima di scegliere il lavoro
Se l’azienda manca in domande ripetute e pertinenti, analizza l’accesso, la copertura delle informazioni e le fonti indipendenti associate alla sua categoria. Se compare per alcune esigenze ma non per altre, verifica se quella differenza riflette un limite reale dell’offerta. Se viene consigliata con informazioni sbagliate, la priorità è l’accuratezza.
Se la visibilità migliora ma le richieste no, la domanda successiva è commerciale. Le esigenze testate hanno valore? I potenziali clienti reali fanno quelle domande? I referral arrivano su una pagina utile? Il rapporto tra lo shopping con l’AI e le vendite è più ampio di un conteggio delle menzioni del brand, e i report AI di Google misurano ancora un’altra piattaforma e un’altra unità.
Un’analisi della visibilità nella ricerca AI dovrebbe rendere espliciti questi confini. Dovrebbe lasciarti una baseline definita, prove conservate e priorità adatte alla tua azienda, non la promessa di “arrivare primo su ChatGPT”.
La tua azienda potrebbe avere un problema di visibilità. Accertarlo con cura è il primo vero passo di ottimizzazione.